产品定位和规格
 🔍 点击查看原图
Muse Ember 由 Meta Superintelligence Labs 发布,可在 Meta Model API 和 Muse Code 里使用。官方文档里的核心规格如下。
| 项目 | 说明 |
|---|---|
| 产品名 | Muse Ember |
| 发布日期 | 2026年11月9日(Meta 研究博客标注) |
| 发布机构 | Meta Superintelligence Labs |
| API 型号 | muse-ember-1.0(标准模式;API 上没有贡献者模式变体) |
| 官方一句话 | 最小、最省的推理模型,用来做智能体整天重复的工作:工具调用、编程子任务、路由、抽取、长文档解析 |
| 输入 / 输出 | 官方文档:文本、图像、视频、音频、PDF 输入,文本输出。Artificial Analysis 的模型页目前只记了文本和图像,音视频和 PDF 以官方文档为准,本文没有另行实测 |
| 上下文 / 最大输出 | API 文档:上下文 1,048,576 token,最大输出 524,288 token。发布文:100 万 token 上下文,「最多 512K」输出。两处写法不同。524,288 等于 512×1,024,和按二进制来读的 512Ki 一致,但发布文既没有写出 524,288,也没有标明 Ki;若把 512K 按千进位读成 512,000,则与文档数字不同。不宜当成同一个数。 |
| 推理强度 | minimal 到 max,默认 max;不支持 none |
| 接口 | Responses、Chat Completions、Messages;基址 https://api.meta.ai/v1 |
| 权重 | 专有模型,参数量未公布,不能本地下载 |
| 系列位置 | 官方说法:Wonder 攻坚,Spark 做编程和智能体主循环,Ember 做可重复的规模化执行。Ember 是第一个用 Muse Wonder Full 训练出来的模型 |
Meta 官方明确表示,Muse Ember 是其专为高频 token 密集型工作打造的紧凑型推理模型,核心针对工具调用、编程子任务、意图路由分类以及长文档解析。Meta 首席 AI 官 Alexandr Wang 指出,在独立评测基准下,Ember 的综合智力表现接近 Muse Spark 1.3,而单任务成本大约降低了 17 倍。
它被设计来干什么
开发者文档写得很具体,适合四种反复出现、边界清楚的工作:
- 主代理分出来的子任务:读文件、跑命令、查资料、做小修补。
- 工具调用密集的环节,单次费用和延迟会累加。
- 把请求分类,再交给相应的处理程序或更大的模型。
- 同一件事对着几千张图、文件或工单并行跑,比如配说明、抽字段、给工单打标签。
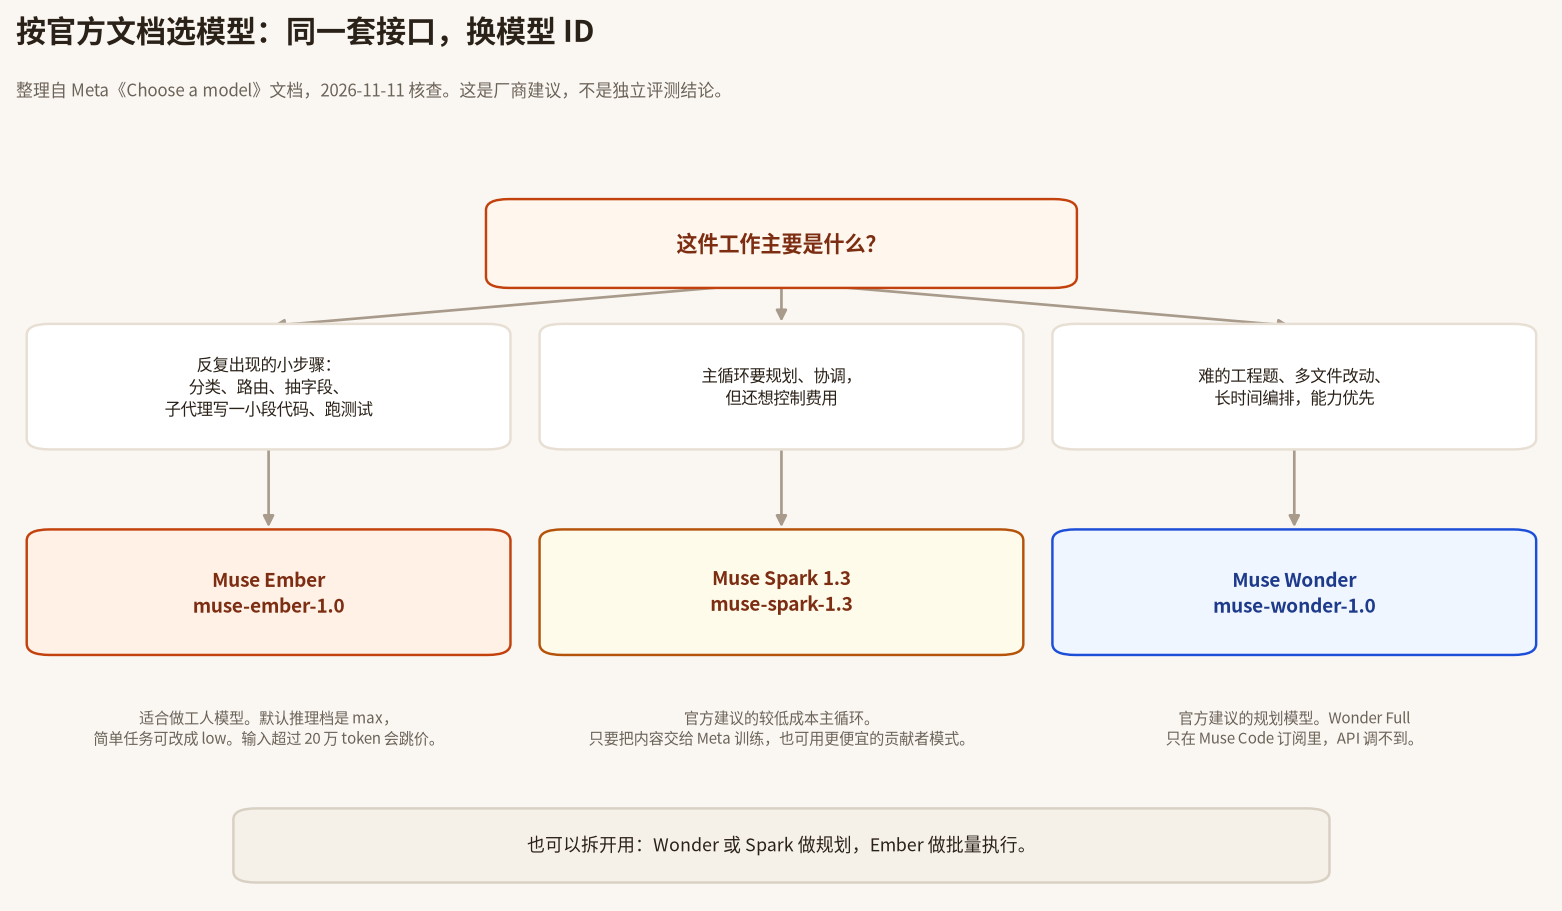
文档同时划了边界:很难的一次性编程、偏知识的问题、偏视觉的编程,请用 Spark 或 Wonder。官方的那句搭配是:「Muse Wonder plans, Muse Ember handles the volume.」
多模态是卖点之一。发布文说,智能体可以直接看截图、图表、扫描件,也可以听语音备忘、会议录音和视频,不必再接一个专门模型。计算机使用、图像理解、工具调用、结构化输出和网页搜索接地,文档都写了支持。搜索接地是另计的:每 1000 次查询 2.50 美元,叠加在 token 费用之上。
在不同测试轮次中,根据任务复杂度与 token 消耗差异,整体处理成本约为 1.33 至 1.59 美元。
和其他 Muse 模型怎么比
三款推理模型走同一套请求体和同一组接口,换模型基本上是改 model 字段。差别主要在默认推理档、价格,以及有没有贡献者模式。
 🔍 点击查看原图
| 项目 | Muse Ember | Muse Spark 1.3 | Muse Wonder 1.0 |
|---|---|---|---|
| 型号 | muse-ember-1.0 |
muse-spark-1.3(推荐;另有 1.2、1.1) |
muse-wonder-1.0 |
| 官方用途 | 高通量、重复执行 | 有一定推理要求的编程和智能体主循环 | 复杂工程和长时间编排 |
| 默认推理档 | max |
high |
max |
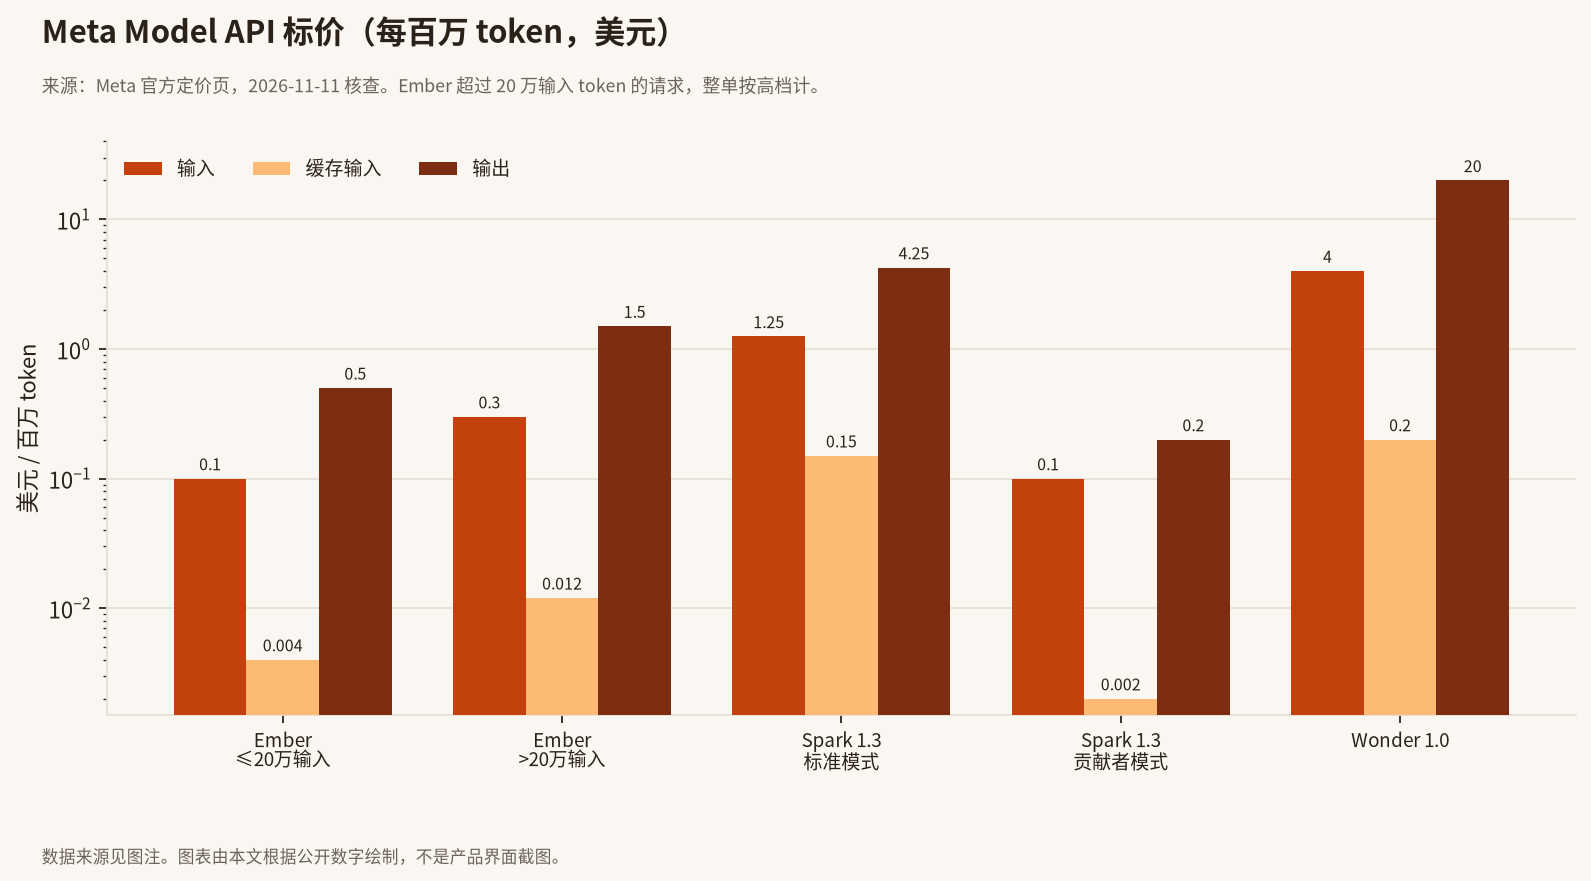
| 标准价(输入 / 缓存 / 输出,每百万 token) | 0.10 / 0.004 / 0.50(输入 ≤20 万);超过则 0.30 / 0.012 / 1.50 | 1.25 / 0.15 / 4.25,上下文长短同价 | 4.00 / 0.20 / 20.00,上下文长短同价 |
| 贡献者模式 | API 上没有 | 有,muse-spark-1.3-contributor,0.10 / 0.002 / 0.20;内容可被用来训练 |
API 上没有。Wonder Full 只在 Muse Code 订阅里 |
| 官方转述的 AA 智力指数(max) | 36 | 37 | 44(来自 AA 评测文,不是 Meta 那张对照表) |
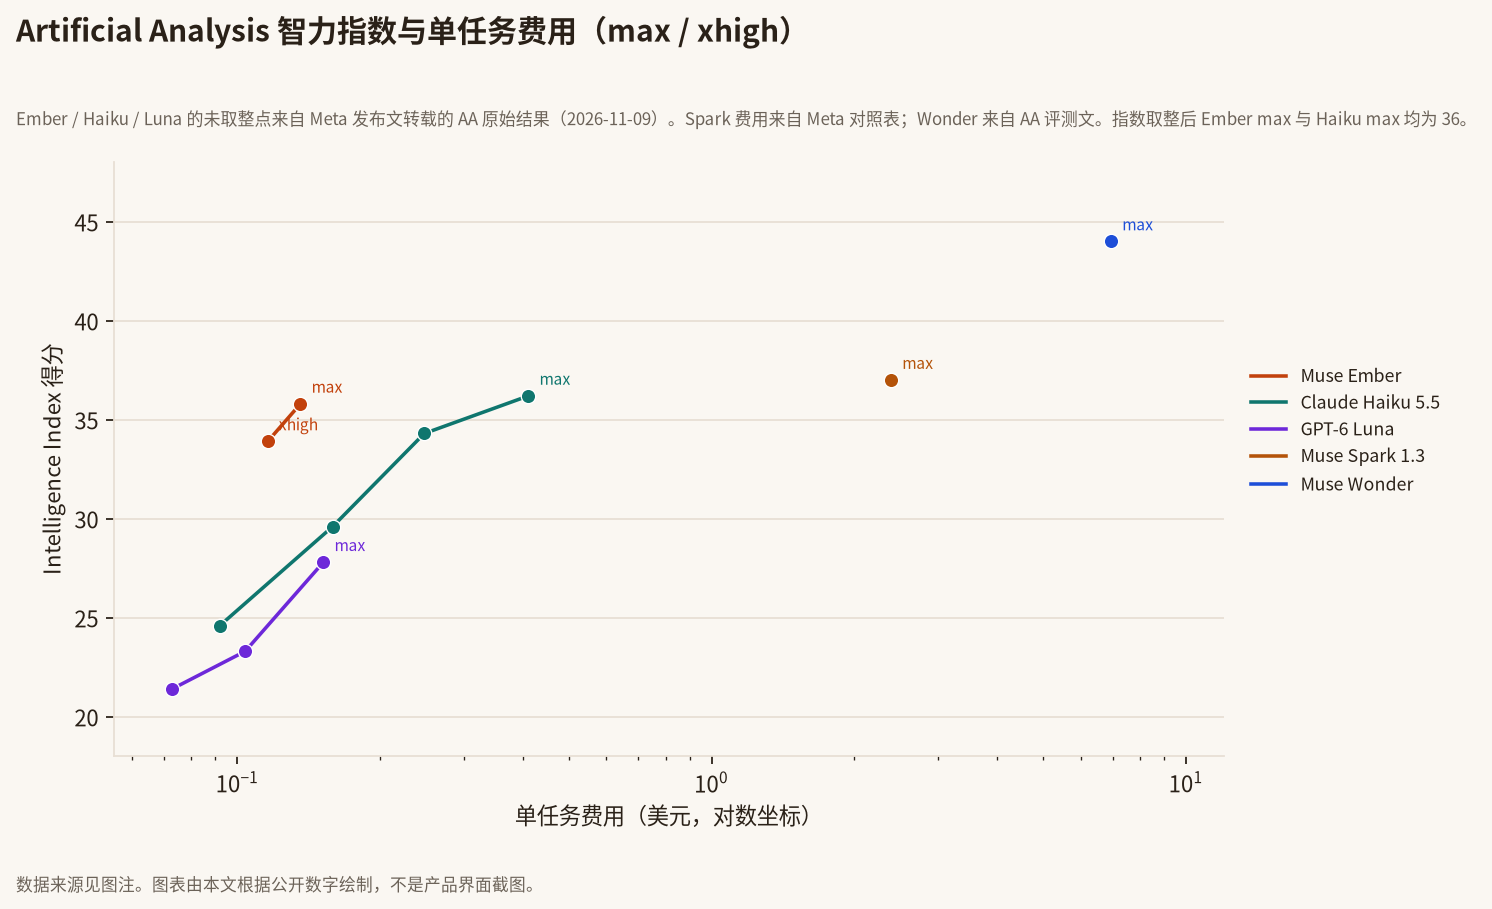
| 官方或 AA 的单任务费用(max) | 约 0.14 美元 | 2.39 美元(Meta 对照表) | 6.95 美元(AA 评测文) |
0.14 对 2.39,大约就是 Wang 说的 17 倍。AA 自己的文章还写:Ember 比 Wonder 低 8 分,单任务费用大约是后者的五十分之一。
贡献者模式那一档,输出比 Ember 还便宜,但前提是允许 Meta 用你的内容训练后续模型。Ember 没有这一档,API 上只走标准模式,官方定价页写明标准模式的内容不用于训练。Muse Code 的订阅默认是贡献者模式,可以在设置里关掉。
此外,Meta 系列还包括专用于图像生成的 Muse Image、音频转写的 Muse Voice Transcribe 以及开源权重的 Muse Spark Open,分别服务于特定的单模态或本地部署场景。
在 Claude Code 一类的工具里,官方建议把 opus 映射到 muse-wonder-1.0,sonnet 映射到 muse-spark-1.3,haiku 和子代理映射到 muse-ember-1.0。
钱怎么算
API 按量付费,没有最低消费。输入里能命中缓存前缀的部分,走缓存价,响应里的 cached_tokens 会告诉你命中了多少。推理过程消耗的 token 按输出计价,并且和可见回复共用输出上限。
速率限制按团队、按模型分开算,不按密钥:Ember 是每分钟 3000 次请求、400 万 token。触发限制会返回 HTTP 429,官方建议指数退避,并尊重 Retry-After。
 🔍 点击查看原图
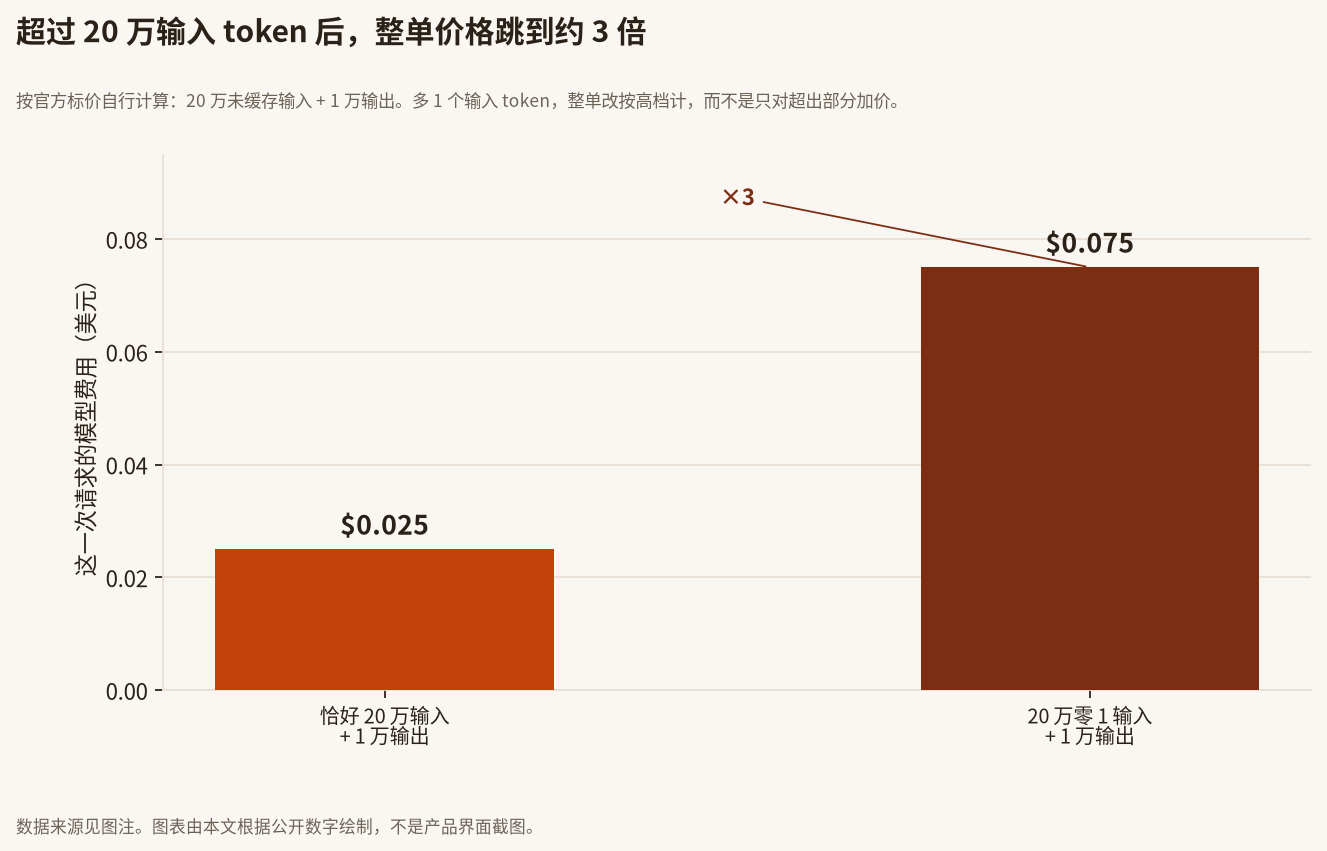
20 万这个门槛值得单独算一笔。按官方标价,20 万未缓存输入加 1 万输出,是 0.025 美元;再多 1 个输入 token,同一笔请求变成大约 0.075 美元。缓存命中和通过 previous_response_id 带过来的对话历史,都计入这 20 万。发布文标题价只写了低档,完整两档在定价页。文档也提醒:在 Muse Code 订阅里,超长请求会更快消耗额度。
和 Haiku、Luna 比,短请求的输入输出标价相同。差别在缓存(Ember 0.004,后两家常见标价是 0.01)和超长请求的加价起点、加价幅度。TechCrunch 当天稿子写 Ember「明显比 Haiku 和 Luna 便宜」,说的如果是标价,并不准确;更接近事实的是单任务费用。AA 解释过原因:在他们的智能体评测里,大部分费用来自缓存读取,Ember 这项便宜 60%,输出 token 大约也只有 Haiku(max)的三分之一。指数评测中 Ember 产出约 1.15 亿输出 token,AA 仍把它评为「略偏啰嗦」,只是比 Haiku 的 max 档少写很多。超过 20 万以后,Ember 的高档仍低于 Haiku 超过 10 万以后的 0.50 / 2.50。超长、输出又多的负载,还是要按自己的 token 结构算,不能只看指数评测的单任务费用。
Muse Code 也可以按量付费,或者订阅。2026年11月11日在模型页看到的档位是:Everyday 每月 5 美元,High 15 美元,Power 50 美元,Maximum 200 美元。Ember 的文档写明,它在所有订阅档和按量付费里都能用。5 美元那一档的广告文案当天仍只点了 Spark、Wonder 和 Muse Image,以模型选择器和 Ember 文档为准。
第三方方面,Wang 在 11月10日 03:56(新加坡时间)发帖让人「give muse ember a go on openrouter」。OpenRouter 页面上的型号是 meta/muse-ember,列出的输入、输出和缓存读取价与 Meta 官网一致;该页另外还列了缓存写入 0.125 美元/百万 token,这是 OpenRouter 页面上的数字,不是 Meta 定价页上的项目。You.com 官方账号当天称,Ember 已在其 Inference Router 上线,并提到至少 99.9% 的运行时间 SLA,以及零数据保留选项。Meta 发布文还写,Ember、Spark 和 Wonder 已在 Google Cloud 和 Oracle Cloud 上提供。Zuckerberg 在 11月10日 05:49(新加坡时间)也发过 Google Cloud 上线的消息。云厂商是否完整支持全部输入模态,要以各家文档为准;有报道称 Google Cloud 预览文档当时写的是文本和图像。
基准:官方表和独立评测要分开看
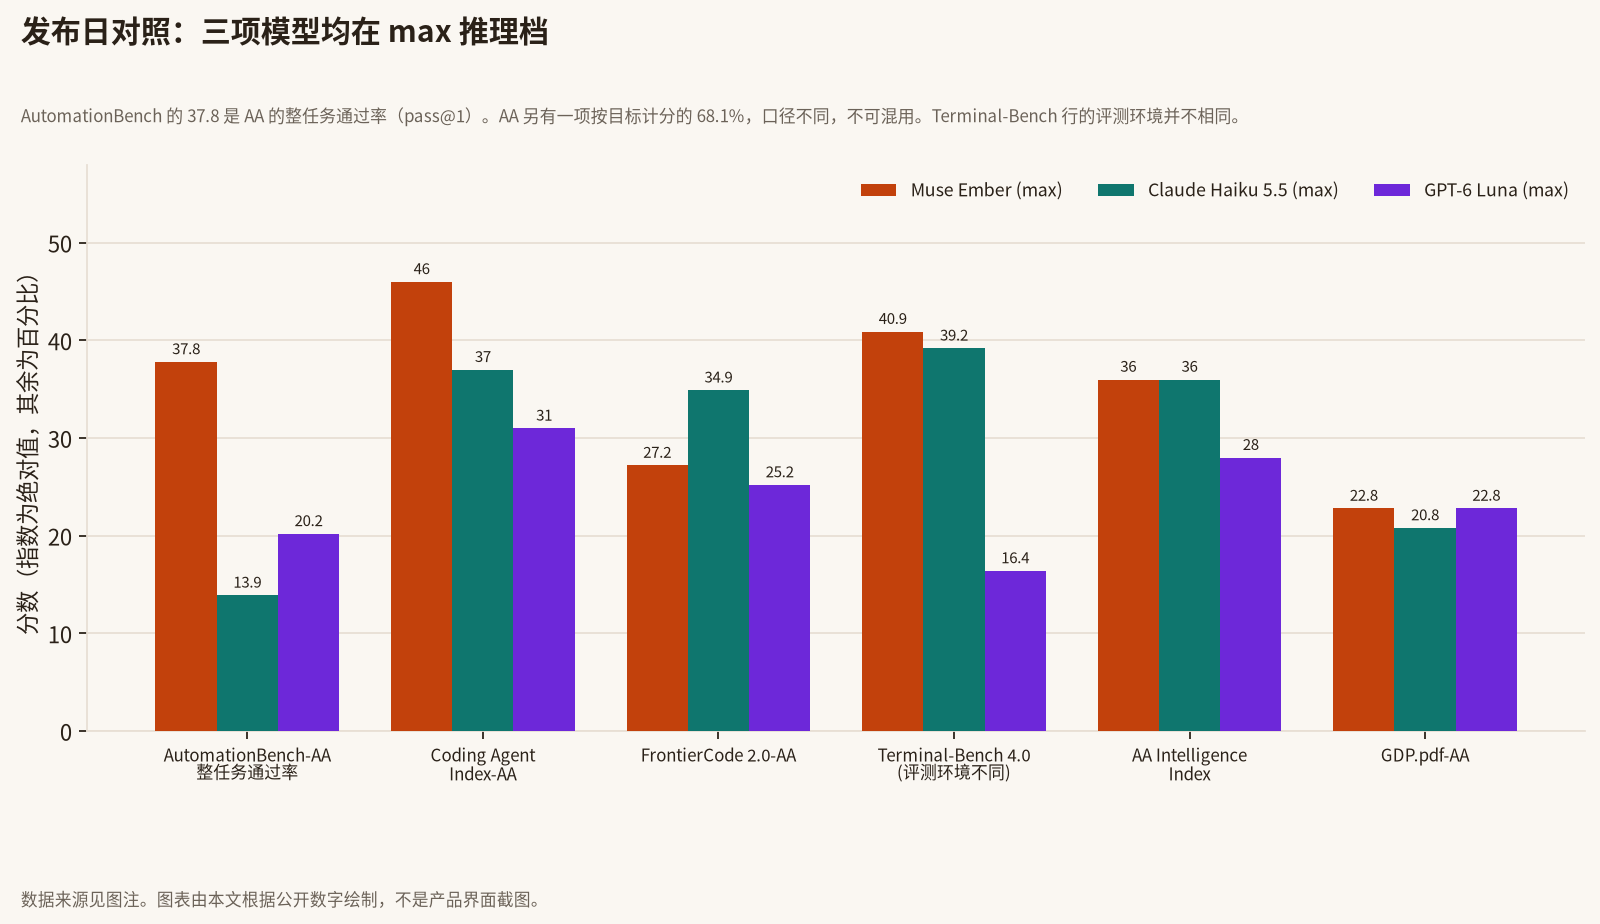
Meta 发布文给了一张对照表,三款模型都在 max 档。表注写明:Artificial Analysis 的结果来自 2026年11月9日公布的 Intelligence Index v5,费用按各家标价估算;内部项目来自 Meta 自己的评测套件。Terminal-Bench 4.0 用的是「各模型已公布的最佳运行环境」:Ember 是 mini-swe-agent,Haiku 是 Anthropic 自行报告的 Claude Code 成绩,Luna 是 Codex 的公开榜。评测环境并不相同。Agents’ Last Exam、个人超级智能指数、OSWorld 2.1、PerceptionBench 是 Meta 内部跑的;竞品内部对照,评估报告自己写的是「尽力而为」,提示词和工具不一定对别人的模型调到最优。
 🔍 点击查看原图
按这张表,Ember 在多数行领先或打平,唯一明显落后的是 FrontierCode 2.0-AA:27.2 对 Haiku 的 34.9。这一项看的是真实仓库里的改动够不够合入。Coding Agent Index-AA 则是 46 对 37 对 31,AA 是把每个模型放进厂家自己的编程代理里跑的:Ember 用 Muse Code,Haiku 用 Claude Code,Luna 用 Codex。OSWorld 2.1 的部分得分是 69.5%,严格全对只有 33.8%。桌面工作流如果不能失败,不要只看部分得分。
有一个数字最容易看岔。发布文把 AutomationBench-AA 写成 37.8 / 13.9 / 20.2,并注明是 AA、strict pass@1。AA 自己的评测文写的是 Ember(max)68.1%,和 Muse Wonder(max)、GPT-6 Astra 同一水平。两个数字都来自 AA,口径不同:37.8 是整条工作流全部目标达成、且没有违规的比例;68.1 是按单个目标给分。如果业务只认「整单做完」,应该看 37.8。
 🔍 点击查看原图
独立评测以 AA 2026年11月9日的文章和模型页为准。要点如下:
- Intelligence Index v5.0.1:Ember(max)36 分,与 Haiku(max)取整后相同;xhigh 是 34 分、约 0.12 美元/任务。Meta 发布文图表里的未取整数字是 35.8 对 36.2。说「打平」可以,说「超过」不合适。
- Ember(max)是当时评分达到 36 或以上、单任务最便宜的模型,约 0.14 美元;Haiku(max)约 0.41 美元。Luna 最高档大约 0.15 美元、28 分。
- 速度(AA,基于 Meta API):到第一个可见回答 token 平均 4.80 秒,输出约 448 token/秒,每个指数任务约 3.1 分钟。同价位中位数是 9.88 秒和 7.5 分钟。
- 知识是明显短板。AA-Omniscience 准确率 21.1%,低于同档的 Haiku 34.7% 和 Gemini 3.8 Flash(high)50.5%。主要原因是它拒答了 64% 的题,幻觉率因此只有 17.4%,大约是 Haiku(max)的一半。知识题请把材料或搜索工具交给它,别指望它硬记。
- Terminal-Bench 4.0 在 AA 的智力指数评测里是 Ember 40.9%、Haiku 32.8%。Meta 表上 Haiku 是 39.2%,用的不是同一套运行环境。
开发者与社区早期实测反馈
这些是个例,不是普遍结论。
根据独立评测机构 Artificial Analysis 的深度拆解:Ember 的基础 token 标价虽与 Haiku、Luna 处于同一价格带,但在代理评测核心的缓存读取成本上大幅降低了 60%,且 Ember 生成同等正确答案所消耗的输出 token 仅为 Haiku 的三分之一左右,这是其单任务费用显著下降的核心原因。
独立站点 AI for Mortals 在 11月9日通过 OpenRouter、用默认 max 档测了五件日常工作:整理乱邮件、回答约 50 页报告的问题、清洗联系人表、把笔记做成 10 页幻灯、写一个小费计算器。他们写:五件都在 20 秒内返回,合计约 1.7 到 1.8 美分;第一封邮件漏了费用,第二轮补上了。同一组提示词下,Haiku 在 max 档花了约 0.116 美元和 14 分钟,其中两件把 6 万 token 上限用在思考上、没有给出答案;改到 high 档后是约 0.024 美元、141 秒,五件都完成。这是他们自己的五件样本,不能外推到所有场景。
发布文里的合作伙伴评语是 Meta 选发的。Cloudflare CTO Dane Knecht 说,尾部延迟比他们对比的那款模型最多快约 30%。You.com 的 Chak Pothina 说,编程任务的 p95 延迟是 2.2 秒。这些数字没有在独立复现里核对过,只能当作当事方自述。
在社区开发者实测方面,工程师 Fahd Mirza 在评测视频中测试了草图生成、混乱表格整理成 Excel 报告、多语言数据提取与电路图推理等多模态任务,展示了 Ember 在结构化提取和多格式输入上的执行效率与稳定性。
怎么通过 API 调用
以下为基于 Meta Model API 官方规范与 OpenAI SDK 兼容格式的标准调用代码示例:
官方文档给的第一通电话是 Responses API,用来做工单分类:
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-ember-1.0",
    "reasoning": {"effort": "low"},
    "input": "Classify this support ticket as billing, bug, or feature request, and give a one-sentence reason: \"I was charged twice for my October invoice.\""
  }'
文档原例没有写 reasoning。这里加上 "low",是因为官方推理文档建议:查找、格式化、翻译这类直接作答的任务用低档;分类也属于这一类。不写的话,Ember 会走默认的 max,思考 token 照样按输出计费。
用 OpenAI 兼容的 Python 客户端,基址指向 Meta:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-ember-1.0",
    reasoning={"effort": "low"},
    input=(
        "Classify this support ticket as billing, bug, or feature request, "
        "and give a one-sentence reason: "
        "\"I was charged twice for my October invoice.\""
    ),
)

print(response.output_text)
如果现有代码走的是 Chat Completions,推理档写在顶层的 reasoning_effort,不要再用 reasoning.effort:
completion = client.chat.completions.create(
    model="muse-ember-1.0",
    reasoning_effort="low",
    messages=[
        {
            "role": "user",
            "content": "Classify this support ticket as billing, bug, or feature request.",
        }
    ],
)
多轮、还要保留思考连续性时,官方建议用 Responses API,靠 previous_response_id 或回放 reasoning.encrypted_content。Chat Completions 对外密钥不会带出可回放的思考内容,每一轮都会重新推理。
在 OpenRouter 上,型号是 meta/muse-ember,基址是 https://openrouter.ai/api/v1。不要把 Meta 官网的 muse-ember-1.0 直接填进 OpenRouter。食谱和并行子代理的完整例子在 Meta Model Cookbook 的 08_muse_ember/,以及开发者博客里的说明。
落地评估与平台接入注意事项
在将 Muse Ember 接入实际业务架构或多智能体工作流时,建议团队充分评估以下边界条件:
- 专有模型与托管依赖:Ember 为云端专有模型,暂不提供本地权重下载;若系统要求完全私有化部署,需考虑开源体系下的 Spark Open 或其他轻量模型。
- 开发者通道专供:目前 Ember 主要通过 API 与开发者集成工具(如 Muse Code、OpenRouter 及各大云厂商)提供服务,未内置于消费级 Meta AI 界面。
- 推理档位按需分配:默认的
max档位适合复杂逻辑推导;对于分类过滤、简单抽取等常规路由任务,建议在low或medium档位测试,可进一步压缩延迟与输出计费。 - 严防上下文阶梯跳价:单次请求的输入 token 达到 20 万时,整笔请求费用将跳涨至 3 倍。在处理大型代码仓库或长文档集合时,务必提前做好拆分与分批预算。
- 边界清晰的协同模式:Ember 在单纯不给上下文的知识问答和大型工程合入评测中仍有局限;最佳生产实践是作为高频“执行手”,由更具规划能力的上位模型进行任务编排与终审。
结合合理的缓存设计与任务切分,Muse Ember 能在工具调用密集的自动化流程中显著降低长期推理开销。