两款模型,定位有什么不同
 🔍 点击查看原图
Fable 5.2 和 Opus 5.5 都在 Anthropic 现行的模型目录里。官方给它们的分工并不一样。
| 项目 | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| 发布 | 2026年11月9日 | 2026年9月22日 |
| API ID | claude-fable-5-2 | claude-opus-5-5 |
| 官方一句话 | 高要求推理、长时间智能体 | 长时间智能体编程与知识工作 |
| 官方建议的角色 | 多数任务不够用时再上调 | 大多数工作的起点、「日常主力」 |
| 相对延迟(官方表述) | Moderate | Moderate |
| 上下文 / 最大输出 | 100 万 / 12.8 万 token | 100 万 / 12.8 万 token |
| 知识可靠截止 / 训练数据截止 | 均为 2026年6月 | 均为 2026年6月 |
| 思考模式 | Adaptive,始终开着 | Adaptive,始终开着 |
| API 默认 effort | high | medium |
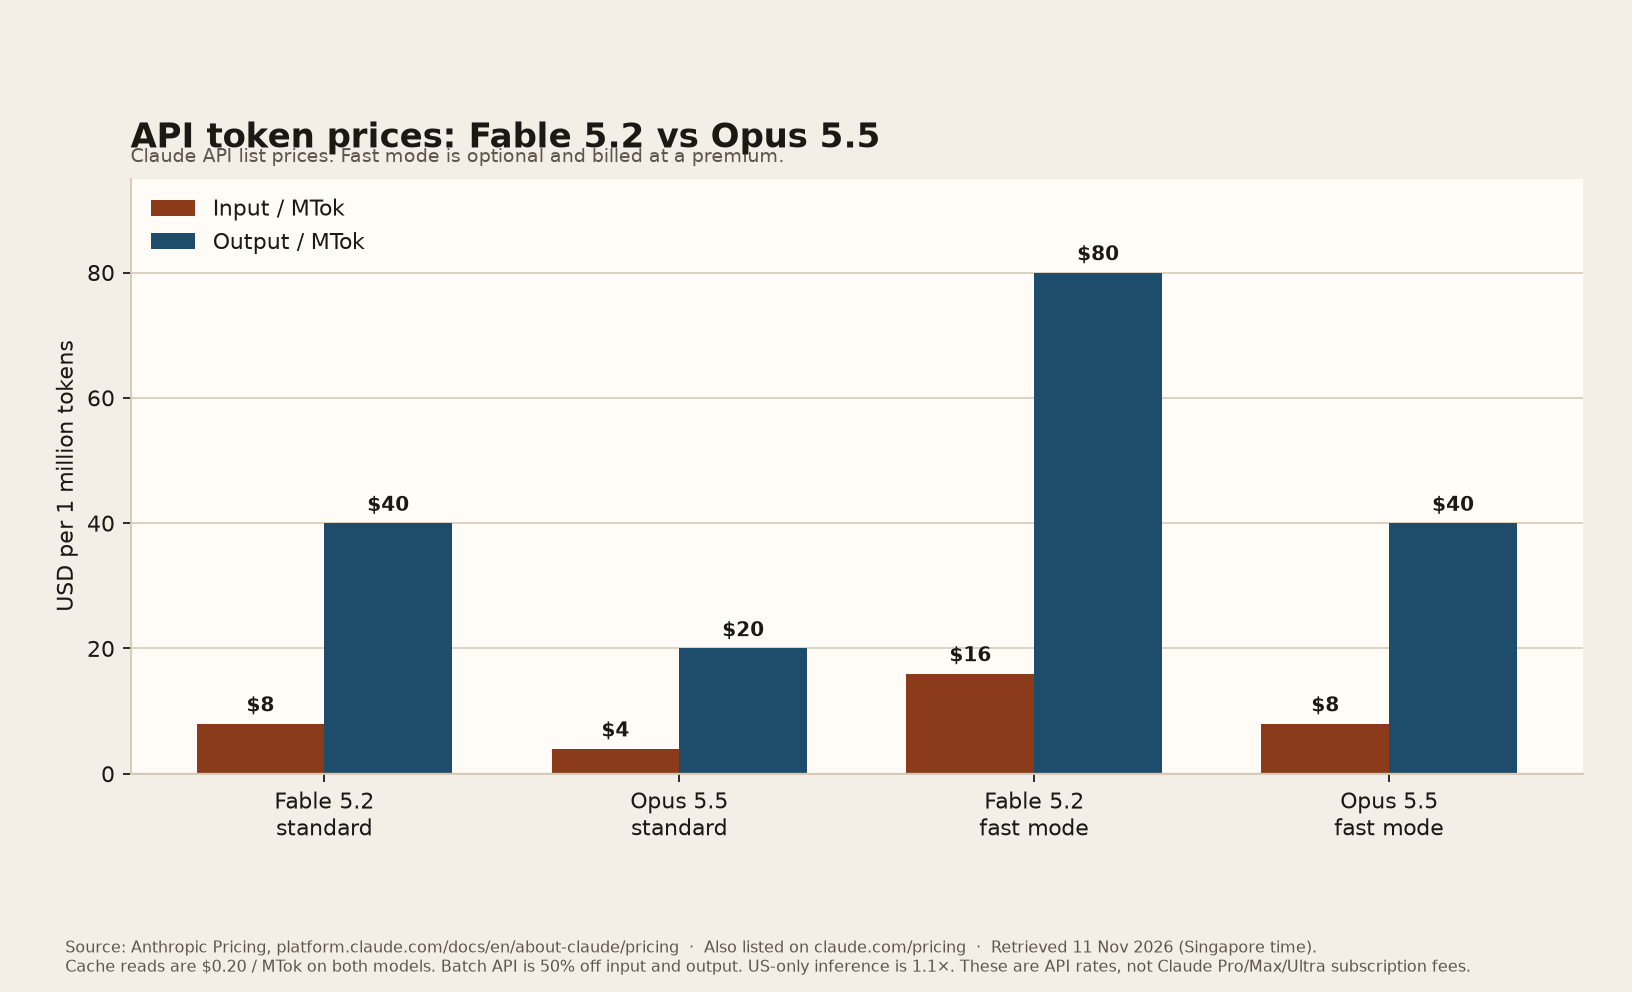
| 标准 API 价(每百万 token) | 输入 8 美元,输出 40 美元 | 输入 4 美元,输出 20 美元 |
| Fast mode | 16 / 80 美元 | 8 / 40 美元 |
| 缓存命中 | 均为 0.20 美元 | 均为 0.20 美元 |
| Batch API | 均为半价 | 均为半价 |
| 承诺下线不早于(Anthropic 自营平台) | 2027年11月9日 | 2027年9月22日 |
同一代阵容中还包含 Sonnet 5.5 与 Haiku 5.5。此外,Fable 与 Mythos 5.2 基于同一套底层架构构建,Fable 内置了更严格的网络安全与生物学防护机制以面向公众开放;Mythos 则专用于 Anthropic 的定向核验项目,两者的安全基准测试不可直接等同。
官方说明里还有一条容易被忽略:Fable 被拦截的网络安全问题会回退到 Opus 4.8,生物学问题会回退到 Opus 5。如果你的工作正好擦到这些边界,体验可能和跑分表不一样。
钱要分两本账:订阅和 API
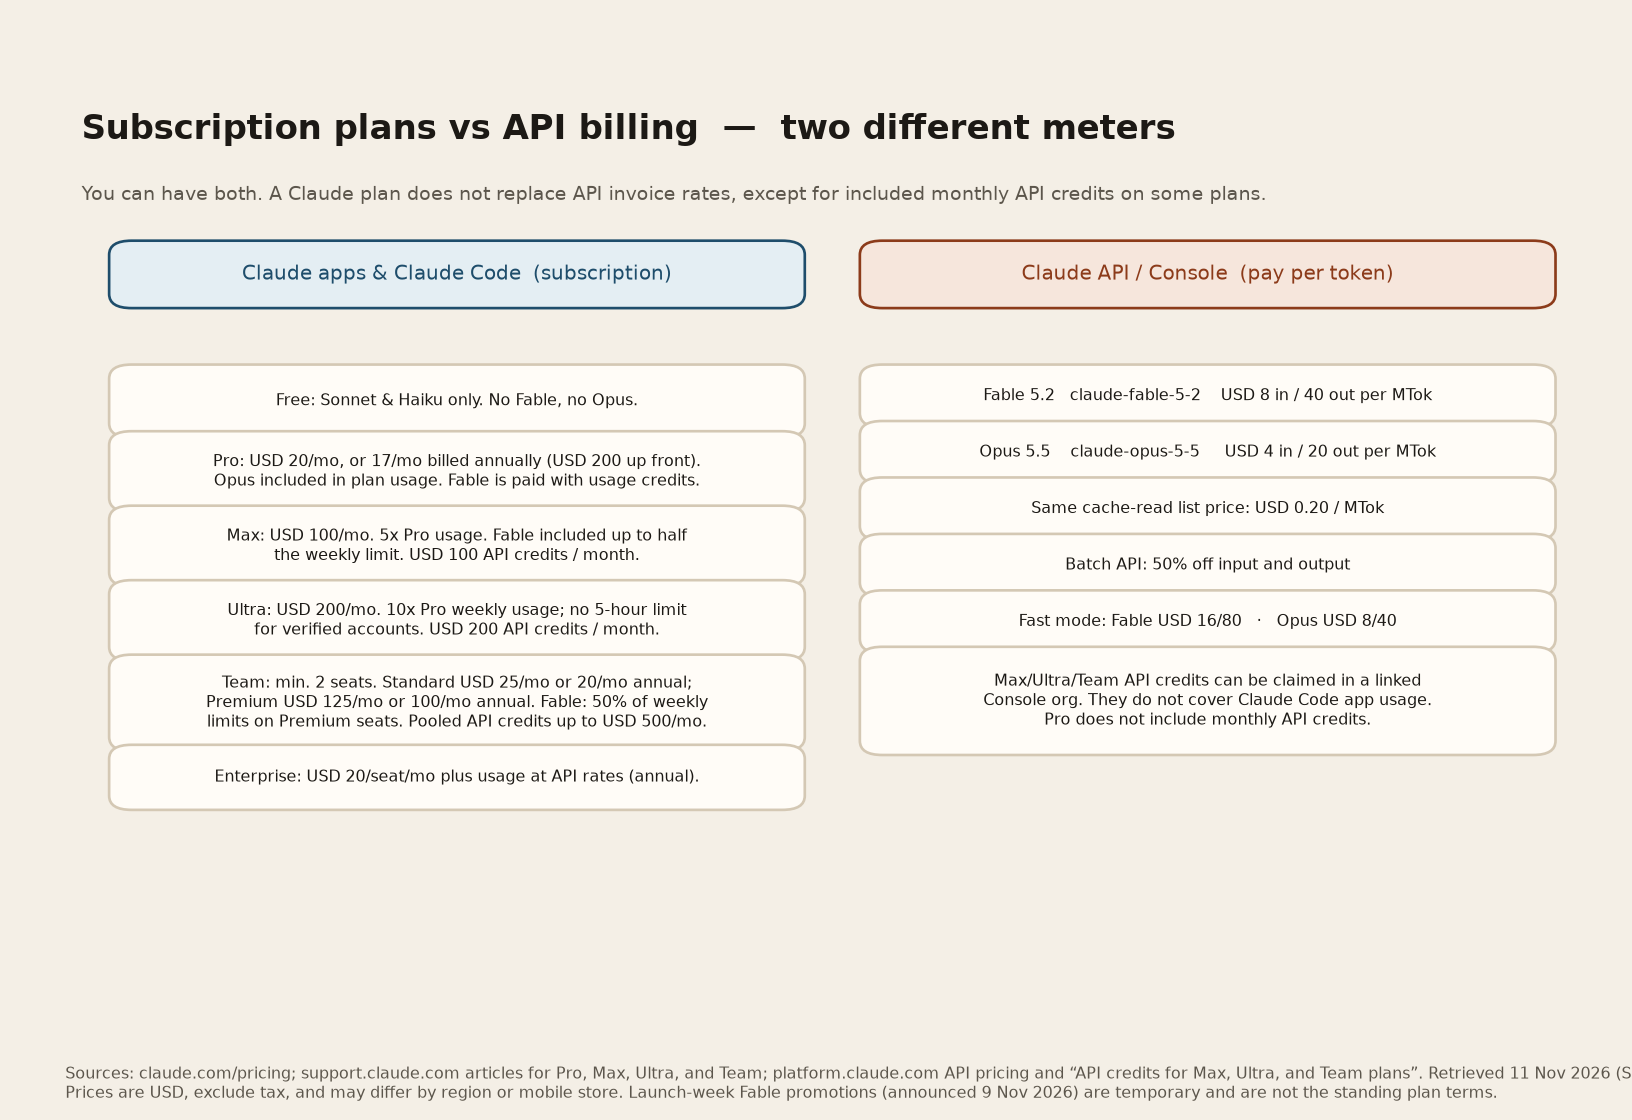
这两套计价不要混在一起。订阅是 Claude 应用和 Claude Code 的用量额度;API 是按 token 另算。有的套餐会附带每月 API 额度,但那是额外的平台积分,不能拿来抵 Claude Code 里已经用掉的订阅额度。
 🔍 点击查看原图
个人订阅(来自 claude.com/pricing 及帮助中心,美元,不含税,地区和手机应用商店可能不同):
- Free:可以用 Sonnet 和 Haiku。没有 Fable,也没有 Opus。
- Pro:月付 20 美元,年付相当于每月 17 美元(一次预付 200 美元)。套餐额度里包含 Opus。Fable 要另用 usage credits 付。
- Max:每月 100 美元,用量是 Pro 的 5 倍。Fable 计入每周额度的上限是一半。每月附带 100 美元 API 积分。
- Ultra:每月 200 美元,每周用量是 Pro 的 10 倍;通过验证的账户没有 5 小时窗口限制。每月附带 200 美元 API 积分。
团队: 至少 2 个席位。Standard 席位月付 25 美元、年付相当于每月 20 美元;Premium 席位月付 125 美元、年付相当于每月 100 美元。定价页写明,Fable 是 Premium 席位每周额度的 50%。团队的 API 积分按席位相加,每月上限 500 美元。
Enterprise: 帮助中心和定价页 FAQ 写的是每席位每月 20 美元,外加按 API 费率计的用量,按年结算。具体合同价以官方销售为准。
Max、Ultra、Team 的 API 积分要在 Claude Console 里把组织和套餐绑在一起才能领取,当期有效、不结转。Pro 没有这项月度 API 积分。
发布初期的限期促销活动可能临时调整额度规则,实际计费请以 Anthropic 官网最新计费面板为准。
API 本身: Fable 标准价正好是 Opus 的两倍;Fable 的 Fast mode(16 / 80)又是它自己标准价的两倍,也等于 Opus Fast mode 再翻一倍。缓存读双方都是 0.20 美元/百万 token,但对 Fable 来说这只相当于基础输入价的 2.5%,对 Opus 是 5%。只在美国推理要乘 1.1 倍。这些是官价,云厂商自己的区域溢价另算。
所以一个很实际的算法是:同样 100 万输入加 100 万输出,标准价 Fable 是 48 美元,Opus 是 24 美元。这还没算思考过程多吐出来的 token。effort 拉得越高,后面这笔通常越大。
官方跑分:Fable 多数项更高,但不是一张简单的「全面碾压」表
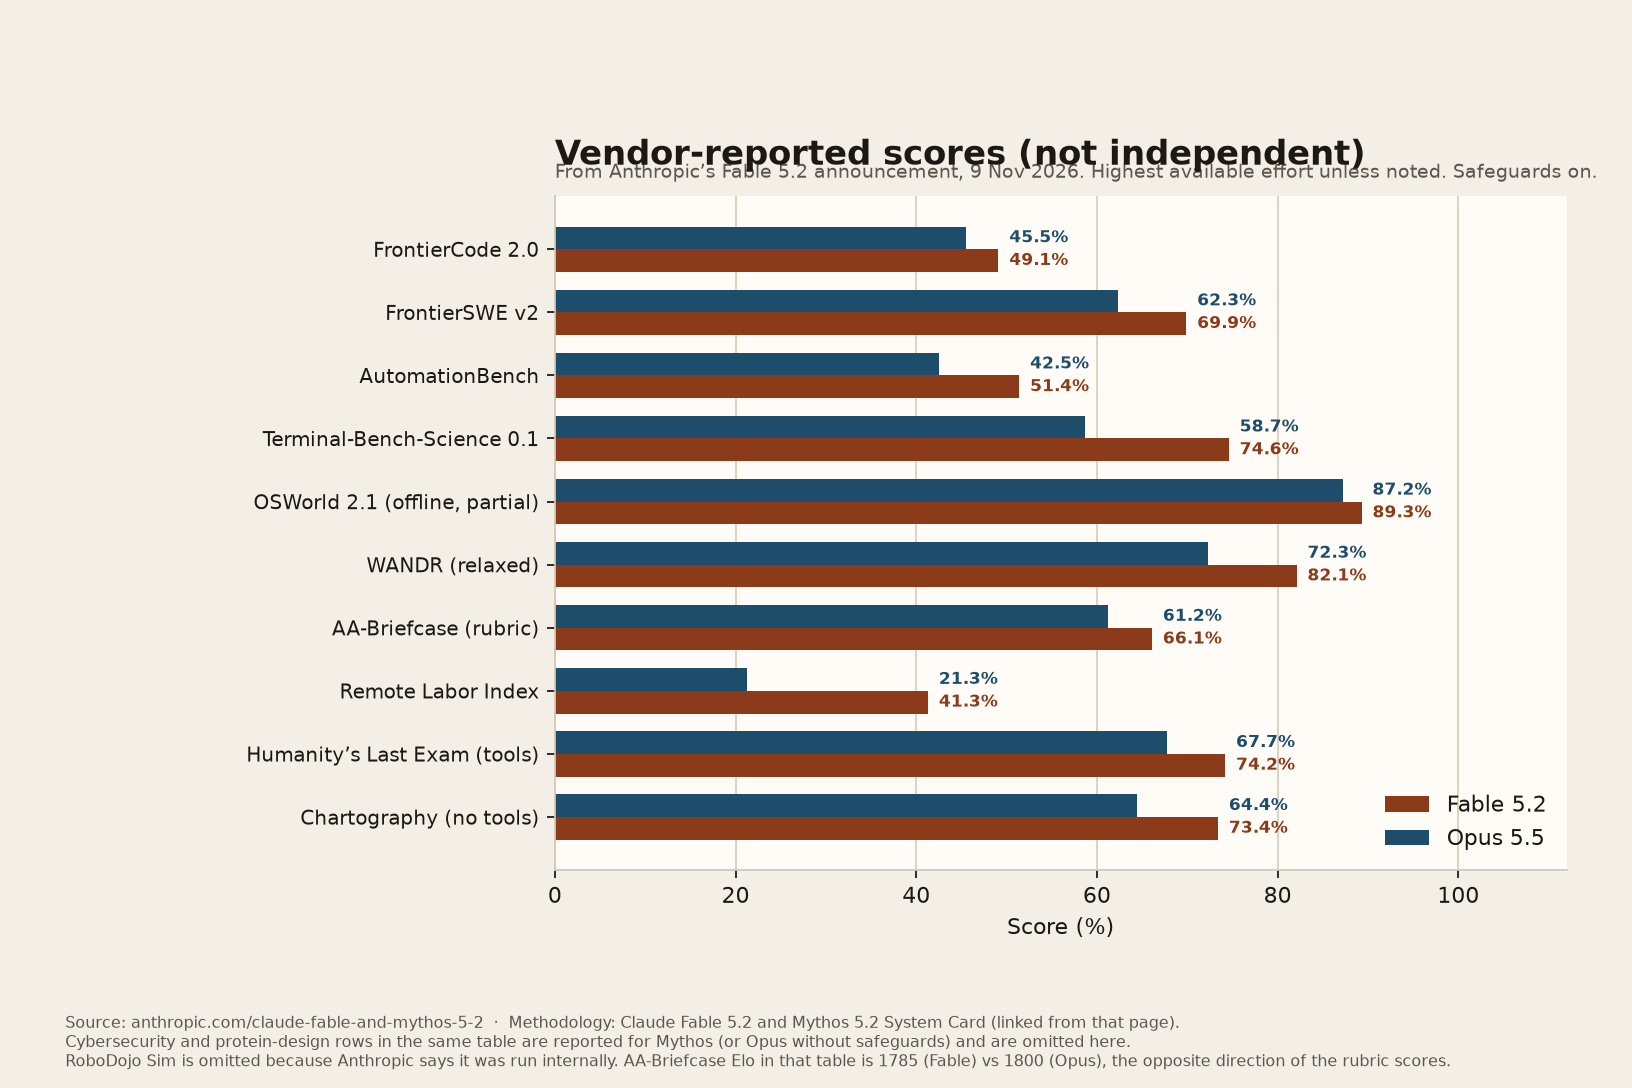
11 月 9 日的发布稿里,Anthropic 放了一张自己测的对照表,并指向系统卡说明方法。稿子里写得很清楚:除另有说明外,用的是各模型当时最高档 effort,而且默认开着防护。下面只摘 Fable 和 Opus 都能直接对比的项,网络安全和蛋白质设计那些标成 Mythos、或标成「Opus 去掉防护」的,不算进 Fable。
 🔍 点击查看原图
按这张表,Fable 在 FrontierCode 2.0、FrontierSWE v2、科学向的 Terminal-Bench-Science、检索向的 WANDR、Remote Labor Index、Humanity’s Last Exam(带工具)以及读图的 Chartography 上都高于 Opus。差距最大的是 Remote Labor Index:Fable 在 High 档是 41.3%,Opus 是 21.3%。电脑操作 OSWorld 2.1(离线、partial)两者接近,89.3% 对 87.2%。
有一处方向是反的,值得单独说。同一张表里,AA-Briefcase 的 rubric 分是 Fable 66.1%、Opus 61.2%;但 Elo 是 Fable 1785、Opus 1800。也就是说,即便在厂商自己的表上,知识工作这一项也不是一边倒。
发布稿另外还给出一些「费用效率」说法,例如在 FrontierCode 2.0 上,Fable 的 High 档大约打平 Opus 的最高分,单任务费用大约一半;在 Humanity’s Last Exam 上,Fable 的 Low 档就能打平 Opus 的最高分,费用不到十分之一。这些都是 Anthropic 自己的测试和表述,不是第三方复现。
官方公布的演示案例涵盖了操作系统原型开发、数学定理形式化推导以及前沿物理计算等极限长任务,展现了大规模长程智能体编排的技术潜力。
Opus 5.5 自己的发布稿(9 月 22 日)比的是当时的 Fable 5.1 和 Opus 5,不能直接拿来当作「Fable 5.2 对 Opus 5.5」的成绩。那篇里强调的是:Opus 5.5 在多数工作上接近 Fable 5.1,典型负载费用比 Opus 5 低约 40%,并且写得更清楚。这些对理解 Opus 的定位有用,但不要和 5.2 的新表混在一起。
独立评测:综合分 Fable 更高,但默认档和最高档是两笔账
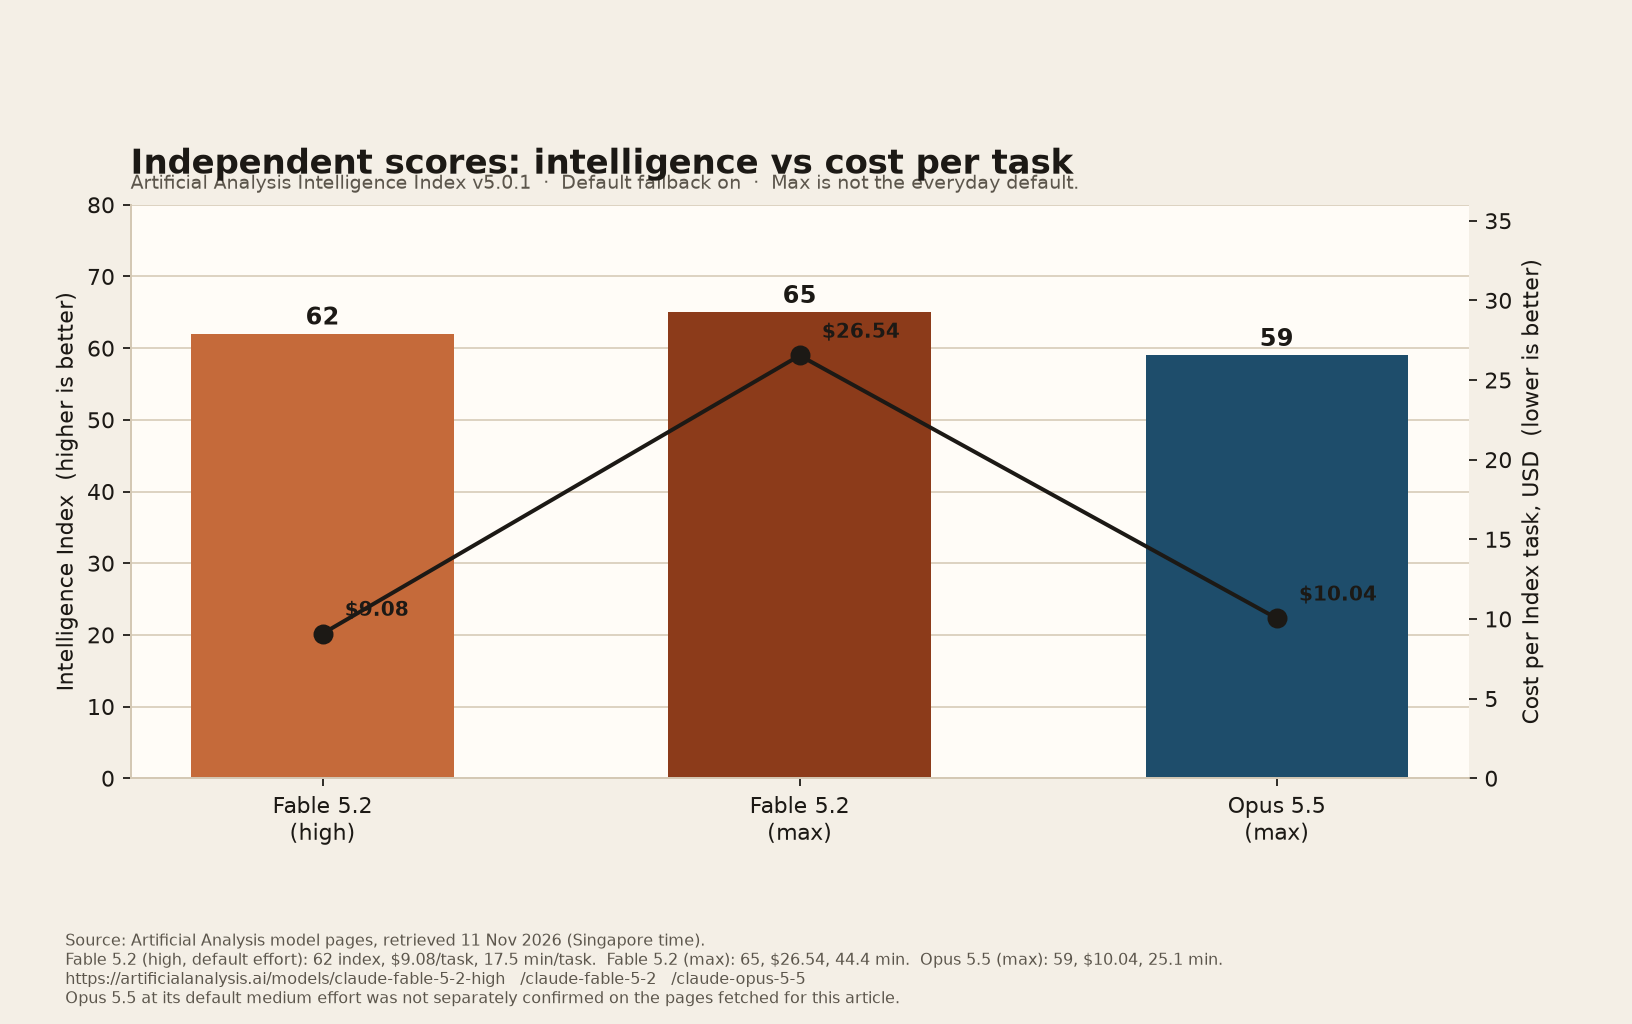
在第三方客观评测方面,Artificial Analysis 的 Intelligence Index v5.0.1 提供了权威的对比参考。该指数综合了 AA-Briefcase、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode 2.0 等 9 项核心基准,并统一在开启官方默认回退机制下测算:
 🔍 点击查看原图
| 配置 | 指数(越高越好) | 单任务费用 | 单任务耗时 | 首个回答 token 耗时 | 输出速度 |
|---|---|---|---|---|---|
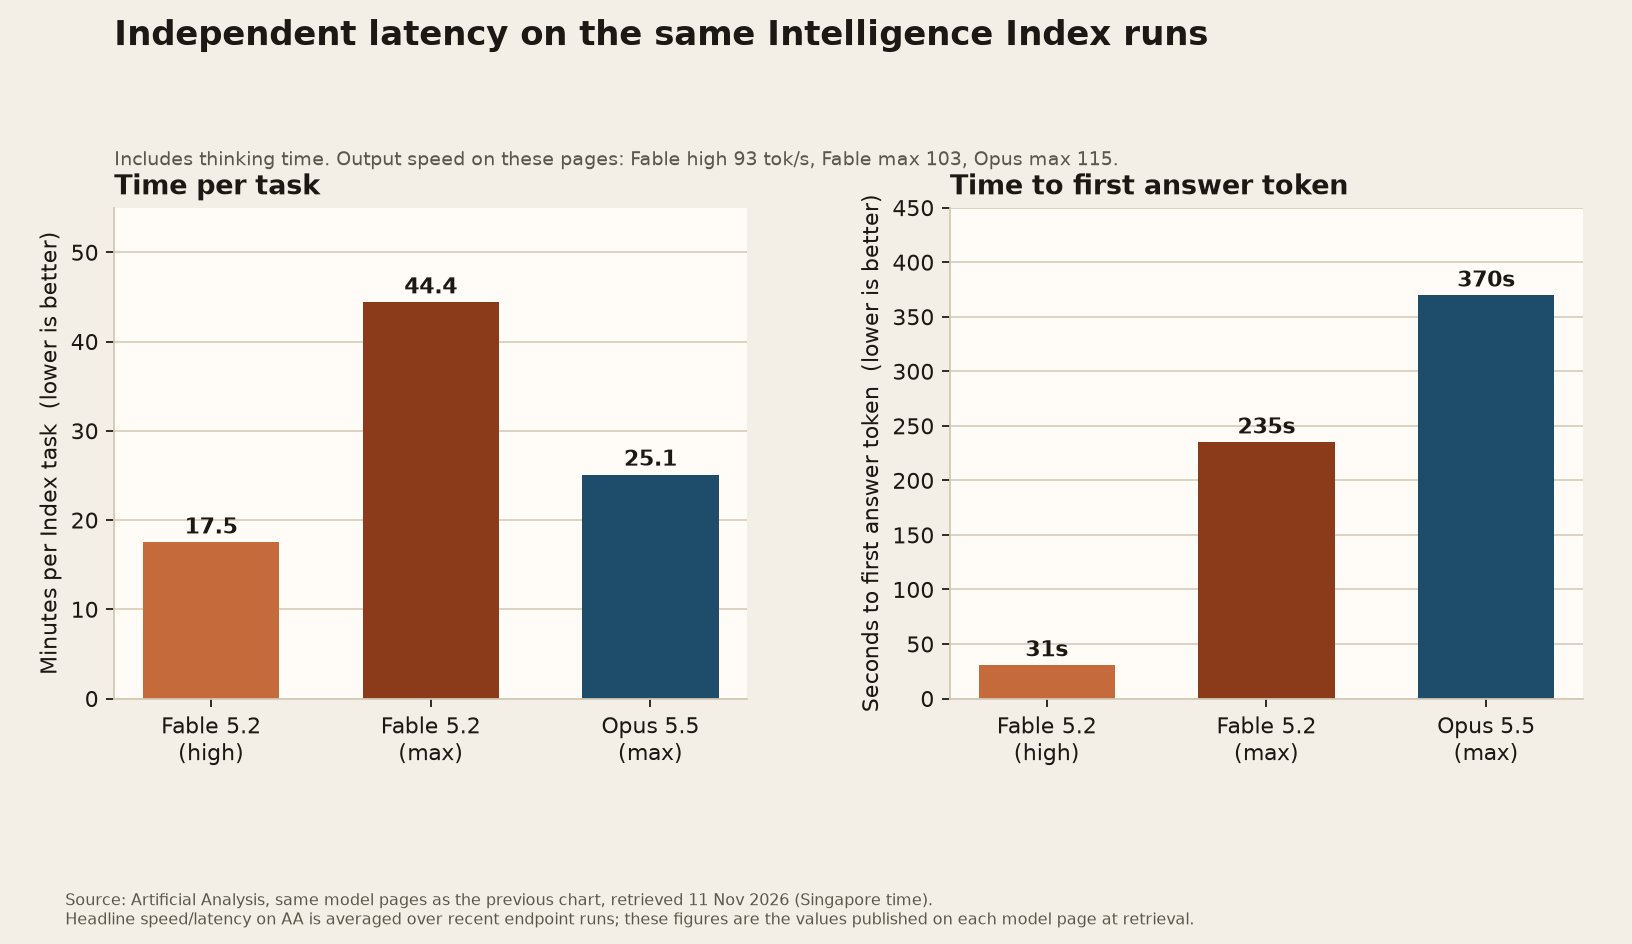
Fable 5.2,high(API 默认档) | 62 | 9.08 美元 | 17.5 分钟 | 30.79 秒 | 93 tok/s |
Fable 5.2,max | 65 | 26.54 美元 | 44.4 分钟 | 235.06 秒 | 103 tok/s |
Opus 5.5,max | 59 | 10.04 美元 | 25.1 分钟 | 369.72 秒 | 115 tok/s |
 🔍 点击查看原图
读这张表时,有三件事情比「谁第一」更重要。
第一,Fable 的默认档并不是 max。high 已经是 62 分、9.08 美元,比 Opus 的 max(59 分、10.04 美元)分高、钱少、也更快跑完。把 Fable 拉到 max,指数只再多 3 分,单任务费用却从 9.08 跳到 26.54 美元,时间也从 17.5 分钟变成 44.4 分钟。
第二,这是他们那套任务的加权费用和耗时,不是你自己仓库里一次改 bug 的账单。输出速度上看,Opus 的 max 还略快(115 tok/s 对 103),但因为思考时间和总输出量不同,整道题不一定更快结束。
第三,从 Artificial Analysis 公布的分项基准详情来看:Fable 5.2 在前沿科学、复杂知识推理和 FrontierCode 2.0 编程生成上优势显著;而在日常商业办公(AA-Briefcase Elo 1785 对 1800)和终端指令操作(Terminal-Bench 4.0 双方均为 60%)等任务中,Opus 与 Fable 处于同一梯队,日常工作差距并不明显。
目前公开的独立评测主要覆盖了各模型的最高与默认推荐档位;对于具体的工程落地,建议团队在自有代码库上建立针对性的小型评测集。
开发者与社区早期实测反馈
从开发者社区初期的实测反馈来看,团队普遍关注模型在实际工程项目中的响应效率与综合性价比。
GitHub 官方账号写过:Fable 5.2 已在 GitHub Copilot 里全面可用;他们的早期测试里,Fable 5.2 比 Fable 5.1 解开了更多任务,步骤和工具调用更少,还完成了更早模型没做成的难题。注意,这条比的是 5.1,不是 Opus 5.5。
有订阅用户(@ashray_malhotra)说,Opus 5.5 已经够省,自己用 100 美元的 Max 就够,还在看 Fable 5.2 会不会成为升级到 Ultra 的理由,并希望去掉 Fable 每周额度 50% 的上限。这是个人用量感受,说明不了别人的账单。
基准测试机构 kilnframe 对固定代码负载进行的横向测算显示:同一任务下 Fable 5.2 耗时 11.1 分钟(6.27 美元),Opus 5.5 耗时 7.6 分钟(2.19 美元),进一步印证了常规工程中 Opus 的性价比优势。
企业早期测试方 Discovered Materials 指出,Fable 5.2 在量子材料计算库 Quantum ESPRESSO 的 DFT 与 DFPT 路径上分别实现了约 36 倍和 9 倍的效率提升,凸显了深度数理推导场景下的加速能力。
在实际工程实测方面,科技博主 Matthew Berman 在评测视频《Fable 5.2 is ridiculous》(视频链接)中,测试了游戏原型、交互式表格及视频编辑工具等大型项目,并测算了高负载下的 token 消耗。他在评测中指出,Fable 5.2 在复杂全栈开发上表现出色,但 Opus 5.5 具备明显的推理速度与成本优势,日常开发依然更推荐以 Opus 为主力。
检索时还能碰到不少 Fable 5、Fable 5.1 的旧视频,那些不能拿来评价 5.2。
架构决策:选型流程与成本优化
 🔍 点击查看原图
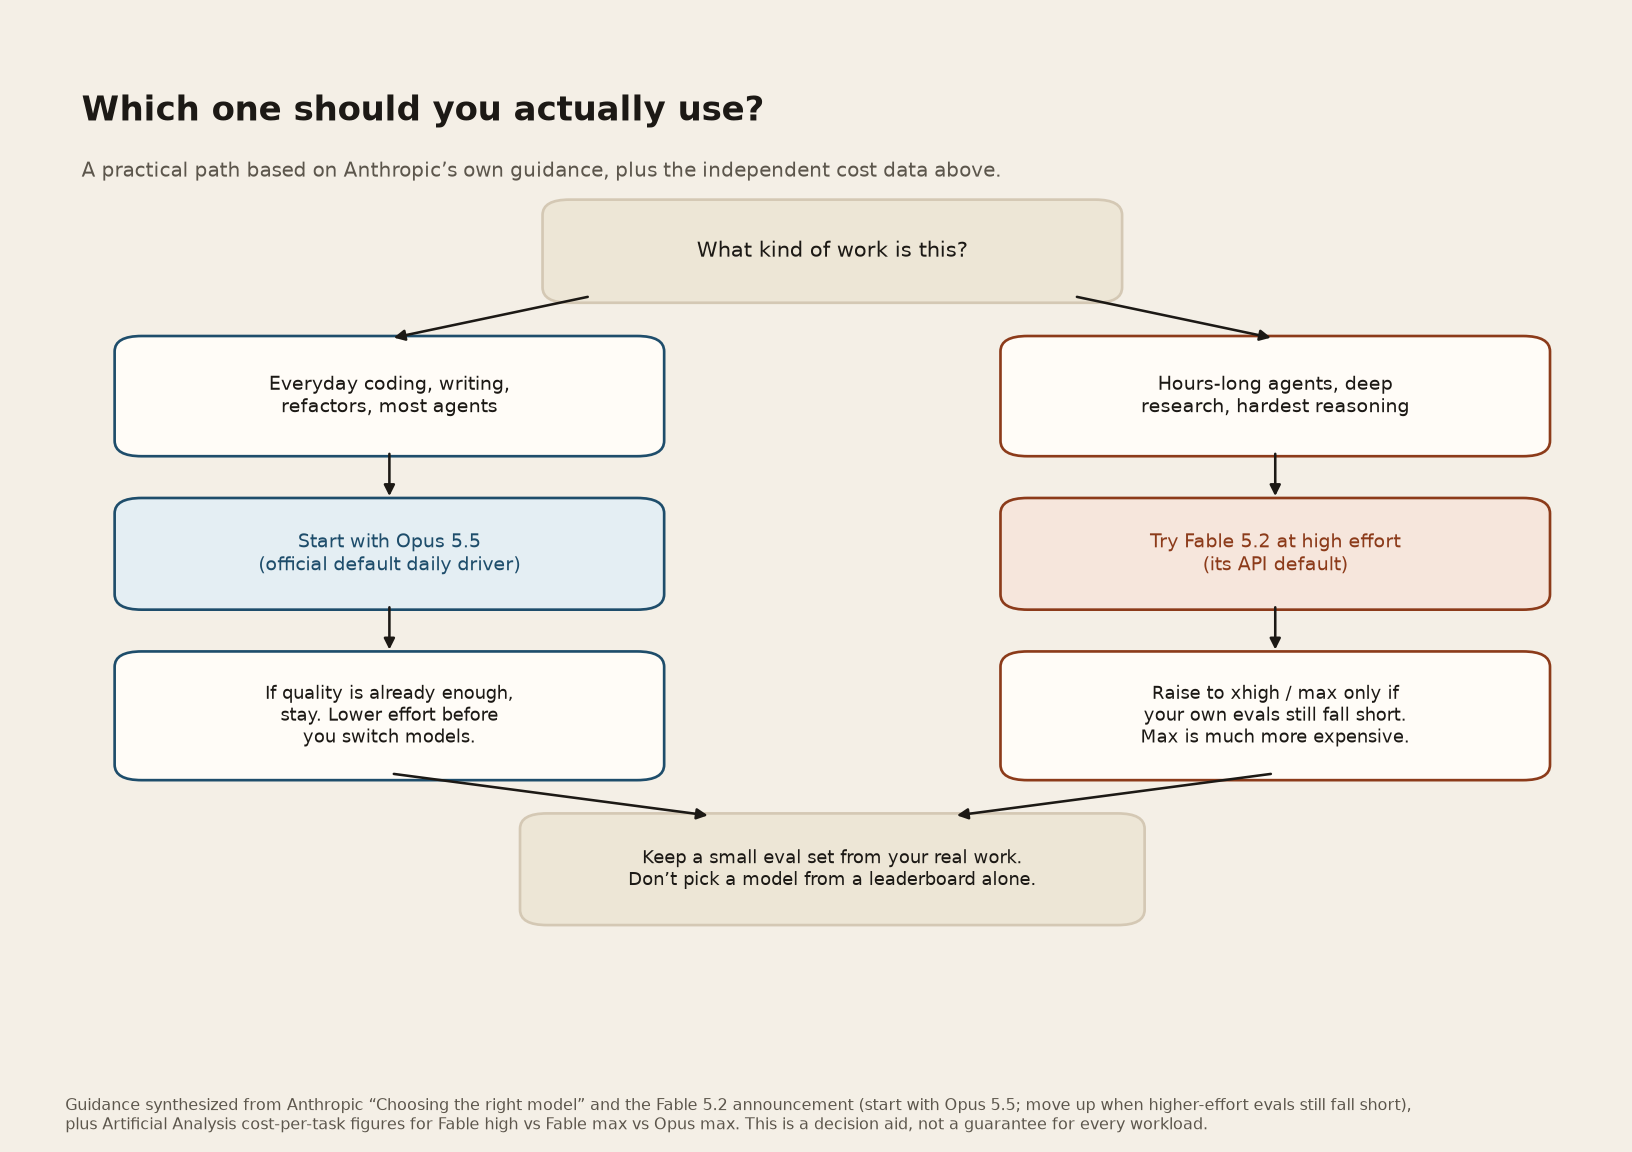
在实际技术选型与架构决策中,建议遵循以下决策路径:
- 先分清你在付哪一种钱。 用网页或 Claude Code 的,看套餐里 Fable 算不算额度、超了是不是要 usage credits。自己接 API 或做产品的,直接按 token 算。Pro 用户尤其要留意:Opus 在套餐里,Fable 默认是另付的。
- 日常工作从 Opus 5.5 起。 这和官方文档一致。先改 effort,再换模型。
- 真正难、真正长的任务,再用 Fable,而且先用
high。 独立评测里,这一档已经比 Opus 的max更划算。只有你自己的评测集还过不了,再试xhigh或max。 - 自备一小份真实任务做对照。 发布两天,公开的独立数据主要是一套综合指数和一条官方 X 帖。网站改版、后台管理、内容生成这类具体场景,现在还没有足够多可核对的第三方报告。
一个可以用的分工是:Sonnet 或 Haiku 处理量大、重复的步骤,Opus 负责日常主路径,Fable 只在关键步骤上当顾问,或者只在明确失败以后再接手。官方文档把这两种结构叫做 advisor 和 orchestrator。
基准评估与选型注意事项
在生产级智能体与自动化开发系统选型中,建议工程团队重点关注以下工程实践准则:
- 动态计费与额度监控:各层级订阅配额与 API 价格会随云厂商政策动态调整,大规模部署前应在团队控制台设立用量告警(Spend Limit)。
- 区分开发日常与极限攻坚:Opus 5.5 在响应延迟与综合成本上具备显著优势,适合作为 80% 代码编写与重构的主力;Fable 5.2 建议仅挂载在架构设计、复杂纠错或需要数小时自主执行的长链任务上。
- 跑分口径与自测回归:厂商公开跑分与第三方独立指数的测试环境和提示词策略存在差异,不可直接以排行榜绝对值替代业务场景实测,建议在自有代码仓库建立包含典型单测的 Mini-Eval 基准。
- 合理设定推理深度(Effort):Fable 5.2 的 high 档位性价比最高;直接拉到 max 会带来成倍的 token 消耗与延迟上升,仅在明确遇到能力瓶颈时再行调高。
持续跟踪模型在真实业务流中的表现并建立回归评测,是控制企业 AI 研发成本并保证系统稳定性的关键。