三份页面,一句话,没有秒表
2026-11-17 对过的是 Ollama 快速入门,以及 Groq 的两页:限额和模型列表。没有给人掐秒。要决定的是第一句短提示该发给哪一台机器,以及每一页真正认的模型名。
Ollama 本地标签写的是 gemma4:e2b。Groq 快速入门示例仍传 llama-3.3-70b-versatile。这两串不能互换。免费档表格和模型页都对不上这个示例,下面的步骤以表格为准。
装上 Ollama,再叫 gemma4:e2b
快速入门的本地标签写着:先下载 Ollama,再执行 ollama pull gemma4:e2b。下载大约 7.2 GB。同一段建议 8 GB 显存,Mac 则看统一内存。上下文开大了还要再占内存。显存不够时,Ollama 可以改用内存,回复会变慢。Linux 上如果服务没在跑,先执行 ollama serve。
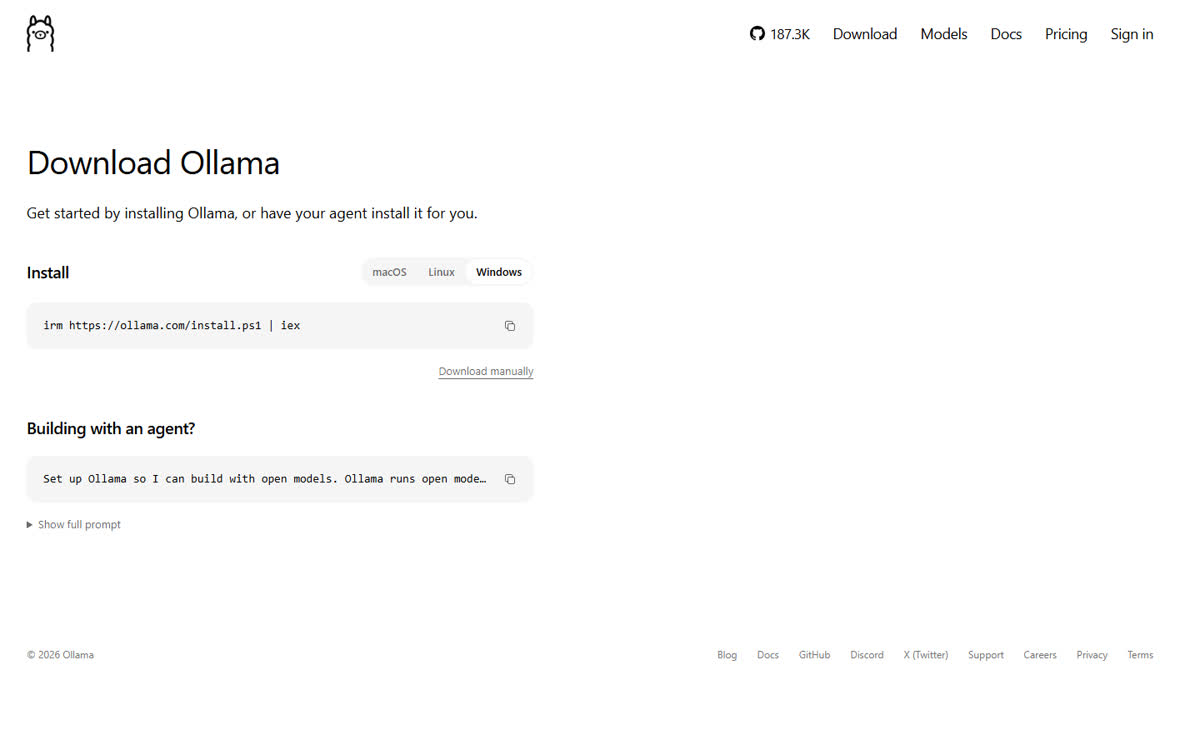
下载页有 macOS、Linux、Windows 三个标签。Windows 上印的是 irm https://ollama.com/install.ps1 | iex。页面源码里还有一行 curl -fsSL https://ollama.com/install.sh | sh。
体验入口:ollama.com/download
拉取完成后,ollama run gemma4:e2b 在这台电脑上打开对话,输入 /bye 退出。程序也可以不进对话,直接 POST 到 http://localhost:11434/v1/chat/completions,正文里 "model": "gemma4:e2b",不带 Authorization。回答在 choices[0].message.content。同一主机还收 http://localhost:11434/api/chat。
这一页的云端标签是另一条产品线:请求打到 https://ollama.com/v1/chat/completions,要 OLLAMA_API_KEY,示例模型是 gemma4:31b。想把权重留在自己机器上,就停在本地标签。
先建 Groq 钥匙,再改掉示例里的模型名
Groq 快速入门从一把 API 钥匙开始。放进环境变量 GROQ_API_KEY。OpenAI 兼容说明把 base_url 设为 https://api.groq.com/openai/v1。
快速入门的 Python 示例把 model 设成 llama-3.3-70b-versatile。模型页上这个 id 在 Llama 3.3 70B Enterprise 那一行,价格和限额两格都写着 Contact Sales。2026-11-17 抓到的免费档各行里没有它。第一条请求把示例字符串换成 openai/gpt-oss-20b。
| 核对项 | Ollama 本地 gemma4:e2b | Groq 的 openai/gpt-oss-20b |
|---|---|---|
| 跑在哪 | 这台电脑的 11434 端口 | api.groq.com/openai/v1 |
| 钥匙 | 本地标签不需要 | 在 console.groq.com/keys 创建 |
| 页面印出的体积或上限 | 下载约 7.2 GB,建议 8 GB 显存 | 免费档标签:30 RPM、1K RPD、8K TPM、200K TPD |
| 官网标价 | 本地标签没有按次价格 | 模型页:输入 $0.075、输出 $0.30 / 百万 token |
| 页面列出的速度 | 快速入门没写 | 模型页写这个 id 约 1000 token/秒。数字来自该页,本篇没有另行计时 |
| 不要盲抄的 id | 云端示例是 gemma4:31b,还要钥匙 | 快速入门示例是 llama-3.3-70b-versatile |
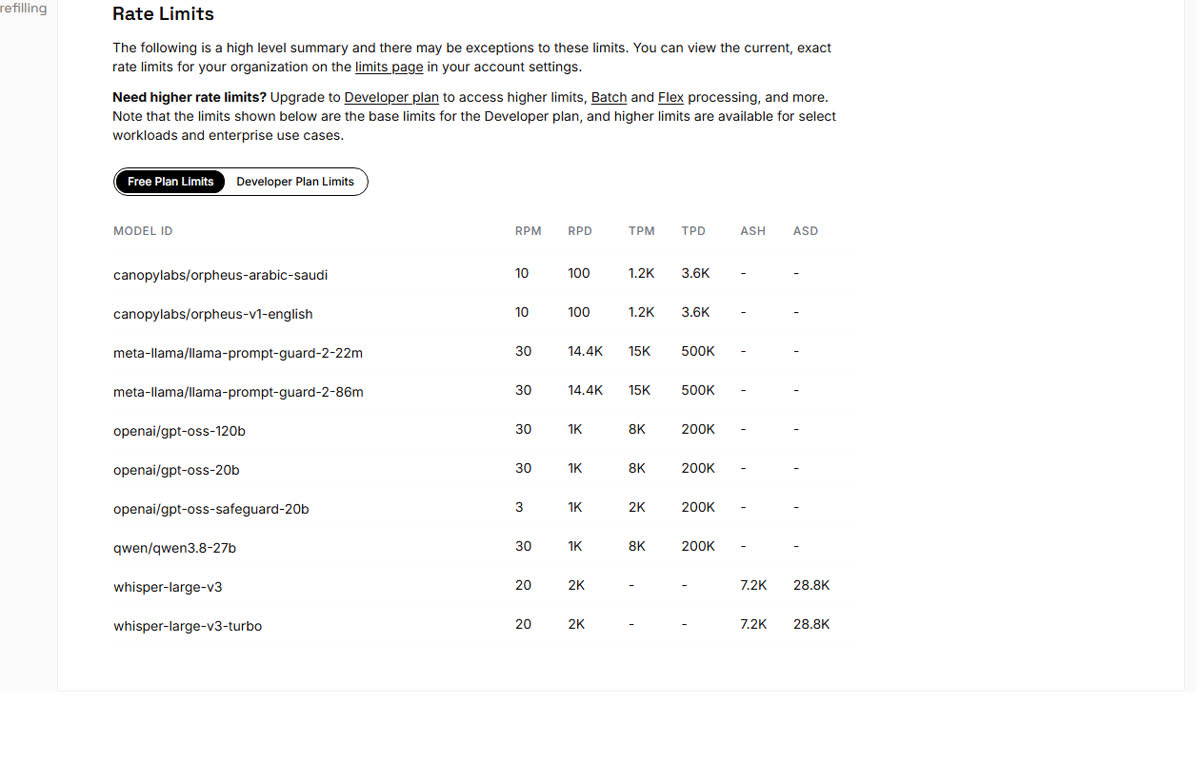
看这张图时,把标签上方那句一起读。那句写:下面列出的限额是 Developer 方案的基础额度。可是选中的标签是 Free Plan Limits,这一行却是 30 RPM。同一页还给 Developer Plan Limits 准备了另一行:同一 id 为 1K RPM、500K RPD、250K TPM,TPD 是一条短横线。模型页的 Developer 列对得上 1K RPM 和 250K TPM,旁边就是 $0.075 / $0.30。缓存命中的 token 不计入限额。限额按组织算,同一组织里再加一把钥匙,不会另给一份额度。超限返回 HTTP 429。Groq 写明,这个组织的准确数字以账号里的 Limits 页为准。
权重该放在哪一台机器上
果断选择 Ollama:如果这句提示必须留在这台电脑上,手头有大约 8 GB 显存或 Mac 统一内存,并且愿意为 gemma4:e2b 留出 7.2 GB 磁盘。第一条验收是 localhost:11434 不带钥匙就能回一句话。
果断选择 Groq:如果权重不必下到笔记本,模型名用 openai/gpt-oss-20b,并且调用量不超过该组织在账号 Limits 页上的当前 RPM。免费档标签把这一行印成每分钟 30 次、每天 1K 次、TPM 8K、TPD 200K,标签上方同时写这些数字是 Developer 基础额度。发送这个 id,不要发送快速入门示例里的那个。
一批请求先打开 Developer Plan Limits 标签、模型页上的价格行和账号 Limits 页,再决定哪一行算数。两个标签印出的 RPM 不一样。客户端对外发布前,把快速入门、限额页和模型页再打开一次。2026-11-17 这一天,示例 id 和免费档各行已经指向不同的模型。